
Harness는 어떻게 “일회성 지시”를 “재사용 가능한 팀”으로 바꾸는가
이 글은 원본 저장소 revfactory/harness를 다룹니다.
Harness는 어떻게 “일회성 지시”를 “재사용 가능한 팀”으로 바꾸는가
도메인 한 문장을 에이전트 팀과 스킬 세트로 바꿔 파일로 남기는, 코드 없는 메타 스킬의 내부 원리
들어가며 — Harness가 뭔가요?
Harness는 Claude Code용 플러그인입니다. 사용자가 "하네스 구성해줘" 또는 "build a harness for this project"라고 한마디 하면, 그 도메인에 맞는 전문 에이전트 팀과 그들이 쓸 스킬을 자동으로 만들어 파일로 저장합니다.
이 저장소를 처음 열면 조금 당황스럽습니다. 코드가 한 줄도 없기 때문입니다.
harness/
├── .claude-plugin/plugin.json      # 플러그인 명세
├── skills/harness/
│   ├── SKILL.md                    # ← 이게 제품의 전부입니다
│   └── references/                 # ← 그리고 이 6개 문서
│       ├── agent-design-patterns.md
│       ├── orchestrator-template.md
│       ├── team-examples.md
│       ├── skill-writing-guide.md
│       ├── skill-testing-guide.md
│       └── qa-agent-guide.md
└── README.md
SKILL.md 하나와 레퍼런스 문서 6개. 이게 전부입니다. 실행되는 것은 Claude Code이고, Harness는 “이럴 땐 이렇게 팀을 짜라”고 적어놓은 지시서입니다.
그래서 이 저장소를 이해한다는 건 소프트웨어 아키텍처를 읽는 일이 아니라, 여기 적힌 설계 방법론을 읽는 일입니다.
이름부터 봅시다. 하네스(harness)는 원래 마구(馬具) — 말에게 채우는 장비입니다. 마구는 말의 힘을 없애지 않습니다. 방향만 잡아줍니다.
Harness가 하려는 일도 정확히 그렇습니다. AI의 능력을 제한하는 게 아니라, 여러 AI가 각자 어디를 맡고 서로 어떻게 이어질지를 미리 정해두는 것입니다.
실행 요건 하나:
Harness의 기본 실행 모드인 ‘에이전트 팀’은 Claude Code의 실험 기능입니다.
CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1환경변수가 설정되어야TeamCreate·SendMessage·TaskCreate가 동작합니다.
이 글은 Harness를 처음 보는 사람도 이해할 수 있도록, 이 메타 스킬을 떠받치는 세 가지를 top-down 방식으로 설명합니다.
- 왜 하나가 아니라 “팀”인가 — 에이전트를 늘리는 게 왜 그냥 낭비가 아닌가?
- 팀을 어떻게 “글로 적나” — 설계된 팀은 어떤 파일로 남는가?
- 만든 다음은? — 만들어진 하네스를 어떻게 검증하고 진화시키는가?
가장 중요한 한 문장
Harness의 설계 원칙은 저장소 곳곳에 흩어져 있습니다. 한 문장으로 압축하면 이렇습니다.
Agents are who. Skills are how. Orchestrators are when.
(에이전트는 ‘누가’, 스킬은 ‘어떻게’, 오케스트레이터는 ‘언제’를 담는다.)
무슨 뜻일까요? 여러 AI에게 일을 시킬 때 우리가 결정해야 하는 건 사실 세 가지뿐입니다.
| 질문 | 예시 | 누가 담당? | 사는 곳 |
|---|---|---|---|
| 누가 하는가 | “보안 관점으로 볼 전문가가 필요해” | 에이전트 (전문가 페르소나 + 행동 원칙) | .claude/agents/{name}.md |
| 어떻게 하는가 | “보안 리뷰는 이런 절차로 한다” | 스킬 (절차적 지식 + 도구 번들) | .claude/skills/{name}/SKILL.md |
| 언제 하는가 | “리뷰는 구현이 끝난 뒤, 셋을 동시에” | 오케스트레이터 (조율 스킬) | .claude/skills/{domain}-orchestrator/SKILL.md |
Harness는 이 셋을 물리적으로 다른 파일에 나눠 담습니다.
엄밀히 하자면 오케스트레이터가 담는 게 “언제”만은 아닙니다. 저장소의 표현을 그대로 옮기면 “누가 언제 어떤 순서로 협업하는가” — 셋을 함께 담습니다. 위 한 문장은 대비를 선명하게 하려고 그중 ‘언제’를 대표로 세운 압축입니다. 저장소가 명시적으로 규정하는 건 스킬(“어떻게 하는가”)과 에이전트(“누가 하는가”)의 2분법이고, 오케스트레이터를 세 번째 축으로 세운 건 이 글의 정리입니다.
왜 굳이 나누느냐 — 이게 이 글 전체의 뼈대입니다. 지금은 “아, 누가·어떻게·언제를 따로 적는구나” 정도만 기억하고 넘어가세요.
주제 1: 왜 하나가 아니라 “팀”인가?
먼저, 오해를 풀자
“에이전트 팀”이라는 말을 들으면 이렇게 생각하기 쉽습니다.
“AI를 5개 띄우면 5배 비싸지기만 하는 거 아냐? 하나가 다 하면 되잖아.”
절반은 맞습니다. 토큰 비용은 실제로 올라갑니다. 하지만 Harness가 노리는 건 양을 늘리는 것이 아니라 일을 나누고 다시 합치는 것입니다.
- ❌ 같은 일을 5명이 중복해서 한다 → 그냥 낭비
- ✅ 서로 다른 관점을 5명이 나눠 맡고, 그 발견을 서로와 공유한다 → 혼자서는 못 보던 게 보임
비유하자면, 만능 담당자 한 명이 밤새워 보안·성능·테스트를 순서대로 훑는 것과, 세 명의 전문가가 동시에 보되 서로 대화하는 것의 차이입니다.
후자에서는 이런 일이 일어납니다: 보안 담당이 “이 SQL 쿼리 주입 가능해 보여요”라고 하면, 성능 담당이 “그 쿼리 N+1이기도 한데요”라고 답하고, 테스트 담당이 “그 모듈에 테스트가 아예 없습니다”라고 붙입니다. 혼자였다면 세 발견이 각각 따로 놀았을 것을, 하나의 이슈로 묶어냅니다.
실행 모드는 3가지
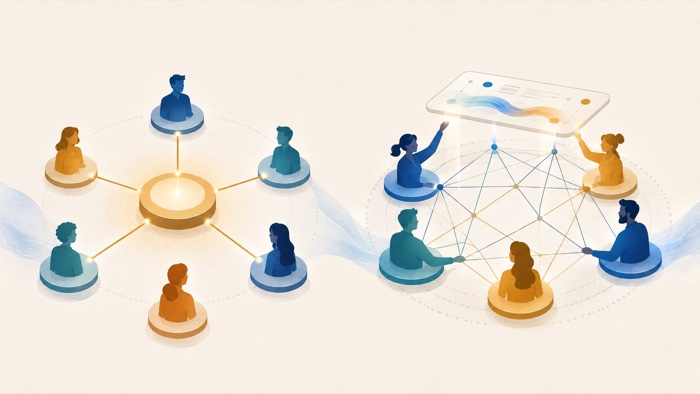
Harness는 에이전트를 굴리는 방법을 세 가지로 정리합니다. 그림으로 보면 차이가 한눈에 들어옵니다.
flowchart TB
    subgraph T["🤝 에이전트 팀 — 리더도 팀의 일원"]
        direction TB
        leader["👤 리더<br/>TeamCreate · TaskCreate<br/>결과 종합"]
        board[("📋 공유 작업 목록<br/>팀원이 직접 claim")]
        subgraph P["팀원 — 이름으로 서로에게 직접 SendMessage"]
            direction LR
            a1["팀원 A"] <--> a2["팀원 B"] <--> a3["팀원 C"]
        end
        leader <--> board
        board <--> P
        leader <-.->|"SendMessage"| P
    end

    subgraph S["📤 서브 에이전트 — 서로 모른 채 결과만 메인으로"]
        direction TB
        main["🧭 메인"]
        b1["서브 A"]
        b2["서브 B"]
        b3["서브 C"]
        main <--> b1
        main <--> b2
        main <--> b3
    end

    classDef team fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    classDef sub fill:#fef3c7,stroke:#d97706,color:#78350f;
    class leader,a1,a2,a3,board team;
    class main,b1,b2,b3 sub;
    style T fill:#f8fbff,stroke:#2563eb,color:#1e3a8a;
    style P fill:#eff6ff,stroke:#93c5fd,color:#1e3a8a;
    style S fill:#fffdf5,stroke:#d97706,color:#78350f;
팀 모드에는 팀원들 사이에 선이 그어져 있습니다. 서브 모드에는 없습니다 — 모든 선이 메인을 거칩니다. 이 선 하나가 두 모드의 전부라고 해도 과언이 아닙니다.
여기서 오해하기 쉬운 지점 하나. 팀 모드의 리더는 정보가 지나가는 허브가 아닙니다. 리더의 일은 팀을 만들고(TeamCreate), 공유 작업 목록에 할 일을 올리고(TaskCreate), 마지막에 결과를 종합하는 것 — 즉 생애주기 관리입니다.
메시지 그래프에서는 리더도 팀원 중 하나일 뿐이라, 리더가 특정 팀원과만 이어져 있거나 모든 대화가 리더를 통과하는 구조가 아닙니다.
| 모드 | 언제 쓰나 | 핵심 도구 | 특성 |
|---|---|---|---|
| 에이전트 팀 (기본) | 2명 이상 협업, 실시간 조율·피드백 교환이 필요, 중간 산출물을 서로 참조 | TeamCreate + SendMessage + TaskCreate |
팀원이 독립 Claude Code 인스턴스로 실행되며 자체 조율 |
| 서브 에이전트 (대안) | 단일 에이전트 작업, 결과만 메인에 돌려주면 충분 | Agent 도구 직접 호출 (run_in_background로 병렬) |
가볍고 빠르고 토큰 효율적 |
| 하이브리드 | Phase마다 성격이 다를 때 | Phase 단위로 팀/서브를 섞음 | 예: 병렬 수집(서브) → 합의 통합(팀) |
Harness는 에이전트 팀을 최우선 기본값으로 못박습니다. 2명 이상이면 일단 팀부터 검토하고, “팀원 간 통신이 정말 불필요한가?”를 자문한 뒤에야 서브 에이전트를 고르라고 합니다.
팀 모드가 특별한 이유는 세 가지입니다.
- 리더를 거치지 않는다 — 팀원 A가 팀원 B에게 직접
SendMessage를 보냅니다. 리더가 병목이 되지 않습니다. - 공유 작업 목록에서 스스로 일을 가져간다 —
TaskCreate로 등록된 작업을 팀원이 직접 요청(claim)합니다. - 유휴 상태가 자동으로 알려진다 — 팀원이 할 일이 없어지면 리더에게 알림이 갑니다.
물론 공짜는 아닙니다. 제약도 명확합니다.
| 제약 | 의미 |
|---|---|
| 세션당 한 팀만 활성 | 동시에 두 팀을 굴릴 수 없음 (단, Phase 사이에 해체 후 새 팀 구성은 가능) |
| 중첩 팀 불가 | 팀원이 자기 팀을 또 만들 수 없음 |
| 리더 고정 | 리더 역할을 중간에 넘길 수 없음 |
| 토큰 비용 | 서브 에이전트보다 확실히 비쌈 |
“세션당 한 팀”이라는 제약 때문에 Harness는 팀 재구성 패턴을 권합니다. Phase마다 필요한 전문가 조합이 다르면, 이전 팀의 산출물을 파일로 저장 → 팀 정리(TeamDelete) → 새 팀 생성(TeamCreate) 순서로 갑니다. 산출물이 파일에 남아 있으니 새 팀이 Read로 이어받을 수 있습니다.
그래서 모드 선택은 이렇게 갈립니다.
flowchart TD
    q1{"에이전트가<br/>2개 이상인가?"}
    q2{"에이전트 간<br/>통신이 필요한가?"}
    team["🤝 에이전트 팀 (기본값)<br/>교차 검증·발견 공유·실시간 피드백"]
    sub1["📤 서브 에이전트도 가능<br/>결과 전달만 필요한 경우"]
    sub2["📤 서브 에이전트<br/>단일 에이전트는 팀 불필요"]

    q1 -->|"Yes"| q2
    q1 -->|"No (1개)"| sub2
    q2 -->|"Yes"| team
    q2 -->|"No"| sub1

    classDef t fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    classDef s fill:#fef3c7,stroke:#d97706,color:#78350f;
    class team t;
    class sub1,sub2 s;
6가지 아키텍처 패턴
모드를 정했으면 이제 팀의 모양을 고릅니다. Harness는 6가지를 미리 정의해 두고, 도메인을 분석해 이 중 하나(혹은 조합)를 고릅니다.
| 패턴 | 구조 | 적합한 경우 | 주의 | 팀 모드 적합성 |
|---|---|---|---|---|
| 파이프라인 | [분석]→[설계]→[구현]→[검증] |
각 단계가 앞 단계 산출물에 강하게 의존 | 병목 하나가 전체를 지연 | 순차 의존이 강해 팀의 이점이 제한적 |
| 팬아웃/팬인 | 분배 → 병렬 N명 → 통합 | 같은 입력을 서로 다른 관점으로 분석 | 통합 단계 품질이 전체 품질을 결정 | 가장 자연스러운 패턴 — 반드시 팀으로 |
| 전문가 풀 | 라우터 → { A | B | C } | 입력 유형에 따라 다른 처리가 필요 | 라우터의 분류 정확도가 핵심 | 필요한 전문가만 부르므로 서브 에이전트가 적합 |
| 생성-검증 | [생성]→[검증]→(문제시)→[생성] |
품질 보장이 중요하고 객관적 기준이 존재 | 무한 루프 방지에 최대 재시도 2~3회 필수 | 유용 — 생성자↔검증자 실시간 피드백 |
| 감독자 | 중앙이 상태를 보며 동적 분배 | 작업량이 가변적, 런타임에 분배를 결정 | 감독자가 병목이 되지 않게 위임 단위를 크게 | 공유 작업 목록과 자연스럽게 매칭 |
| 계층적 위임 | 총괄 → 팀장 → 실무자 | 문제가 자연스럽게 계층 분해되는 구조 | 깊이 3단계 이상은 지연·컨텍스트 손실. 2단계 이내 권장 | 중첩 불가라 1단계만 팀, 2단계는 서브 |
여기서 눈여겨볼 대비가 둘 있습니다.
팬아웃/팬인이 팀 모드의 정석인 이유. 네 명이 각자 다른 각도로 조사할 때, 한 명의 발견이 다른 사람의 조사 방향을 실시간으로 바꿀 수 있습니다. 미디어 담당이 투자 뉴스를 찾으면 배경 담당에게 바로 넘겨 경쟁 구도 분석에 반영시키는 식이죠. 이게 각자 따로 조사해서 나중에 합치는 것과의 결정적 차이입니다.
감독자 vs 팬아웃의 차이. 둘 다 “여러 명이 병렬로”인데, 팬아웃은 작업을 사전에 고정 분배하고 감독자는 진행 상황을 보며 런타임에 동적 조정합니다. 파일 300개를 마이그레이션하는데 어떤 파일이 얼마나 걸릴지 모른다면 감독자입니다.
실전에서는 단일 패턴보다 복합 패턴이 흔합니다. “팬아웃 + 생성-검증”(4개 언어 병렬 번역 → 각각 네이티브 리뷰), “파이프라인 + 팬아웃”(분석은 순차, 구현은 병렬, 통합 테스트는 다시 순차) 같은 조합이죠.
마지막으로 팀 크기. Harness는 규모별 권장치를 못박아 둡니다.
| 작업 규모 | 권장 팀원 수 | 팀원당 작업 수 |
|---|---|---|
| 소규모 (5~10개 작업) | 2~3명 | 3~5개 |
| 중규모 (10~20개 작업) | 3~5명 | 4~6개 |
| 대규모 (20개+ 작업) | 5~7명 | 4~5개 |
팀원이 많을수록 조율 오버헤드가 커집니다. 3명의 집중된 팀원이 5명의 산만한 팀원보다 낫습니다.
정리
Harness는 “AI를 몇 개 띄울까”를 묻지 않습니다. 일을 어떤 전문 영역으로 쪼갤지, 쪼갠 것들이 서로 어떻게 대화할지, 언제 합칠지를 먼저 정합니다.
에이전트 팀이 기본값인 이유는 단 하나 — 팀원끼리 리더를 거치지 않고 직접 소통할 수 있어서, 혼자서는 못 보는 교차 영역 이슈가 잡히기 때문입니다.
주제 2: 팀을 어떻게 “글로 적나”?
이제 설계한 팀을 실제로 어떻게 남기는지 봅시다. Harness의 산출물은 코드가 아니라 마크다운 파일 3종입니다.
산출물 지도
"하네스 구성해줘" 한마디의 결과는 이런 디렉토리입니다.
your-project/
├── .claude/
│   ├── agents/                      # 누가 — 에이전트 정의
│   │   ├── analyst.md
│   │   ├── builder.md
│   │   └── qa.md
│   └── skills/                      # 어떻게 — 스킬
│       ├── analyze/SKILL.md
│       ├── build/
│       │   ├── SKILL.md
│       │   └── references/
│       └── {domain}-orchestrator/   # 언제 — 조율 스킬
│           └── SKILL.md
└── CLAUDE.md                        # 포인터 (트리거 규칙 + 변경 이력)
flowchart LR
    who["🧑 누가<br/>agents/{name}.md<br/>전문가 페르소나<br/>+ 행동 원칙"]
    how["📄 어떻게<br/>skills/{name}/SKILL.md<br/>절차적 지식<br/>+ 도구 번들"]
    when["🕐 언제<br/>{domain}-orchestrator<br/>순서 · 데이터 흐름<br/>+ 에러 핸들링"]
    out(["도메인 목표 정의<br/>→ 실행 가능한 팀"])

    who --> out
    how --> out
    when --> out

    style out fill:#dbeafe,stroke:#2563eb,stroke-width:2px,color:#1e3a8a
① 에이전트 파일 — “누가”
에이전트는 전문가 역할 정의입니다. 구조는 이렇습니다.
---
name: agent-name
description: "1-2문장 역할 설명. 트리거 키워드 나열."
---

# Agent Name — 역할 한줄 요약

당신은 [도메인]의 [역할] 전문가입니다.

## 핵심 역할          # 무엇을 책임지는가
## 작업 원칙          # 판단 기준
## 입력/출력 프로토콜  # 어디서 받고 어디에 쓰는가
## 팀 통신 프로토콜    # ← 팀 모드에서 추가되는 섹션
## 에러 핸들링        # 실패·타임아웃 시 행동
## 협업              # 다른 에이전트와의 관계
실제 파일은 이런 모습입니다. SF 소설 집필 팀의 세계관 담당 에이전트를 보죠.
## 작업 원칙
- 내적 일관성 최우선 — 설정 간 모순이 없어야 한다
- 이야기에 봉사하는 세계관 — 플롯을 방해하는 과도한 설정은 지양

## 팀 통신 프로토콜
- character-designer에게: 사회 구조, 계급 시스템, 직업군 정보 SendMessage
- plot-architect에게: 세계의 주요 갈등 구조, 위기 요소 SendMessage
- science-consultant로부터: 과학적 오류 피드백 수신 → 설정 수정
팀 통신 프로토콜 섹션에 주목하세요. “누구에게 무엇을 보내고, 누구로부터 무엇을 받는지”가 파일에 적혀 있습니다. 이게 없으면 팀원들은 서로 뭘 공유해야 하는지 모른 채 각자 일합니다.
여기서 Harness가 강하게 못박는 규칙이 하나 있습니다. 모든 에이전트는 반드시 .claude/agents/{name}.md 파일로 정의한다. Agent 도구의 프롬프트에 역할을 직접 써넣는 것은 금지입니다. 빌트인 타입(general-purpose, Explore, Plan)을 쓰더라도 파일은 만듭니다. 이유는 셋입니다.
- 파일로 존재해야 다음 세션에서 재사용 가능하다
- 팀 통신 프로토콜이 명시되어야 협업 품질이 보장된다
- 하네스의 핵심 가치가 에이전트(누가)와 스킬(어떻게)의 분리이기 때문이다
빌트인 타입은 이렇게 나뉩니다.
| 타입 | 도구 접근 | 적합한 용도 |
|---|---|---|
general-purpose |
전체 (WebSearch, WebFetch 포함) | 웹 조사, 범용 작업 |
Explore |
읽기 전용 (Edit/Write 없음) | 코드베이스 탐색·분석 |
Plan |
읽기 전용 | 아키텍처 설계, 계획 수립 |
그리고 모델. Harness는 모든 에이전트에 model: "opus"를 쓰라고 규정합니다. “하네스의 품질은 에이전트의 추론 능력에 직결된다”는 이유에서입니다.
② 스킬 파일 — “어떻게”
스킬은 절차적 지식입니다. 에이전트가 일할 때 참조하는 매뉴얼이죠.
skill-name/
├── SKILL.md (필수)
│   ├── YAML frontmatter (name, description 필수)
│   └── Markdown 본문
└── Bundled Resources (선택)
    ├── scripts/    - 반복/결정적 작업용 실행 코드
    ├── references/ - 조건부로 로딩하는 참조 문서
    └── assets/     - 출력에 쓰이는 파일 (템플릿, 이미지 등)
description은 유일한 트리거 메커니즘
여기가 스킬 작성에서 가장 중요한 지점입니다. Claude는 사용 가능한 스킬 목록에서 name과 description만 보고 이 스킬을 쓸지 말지 결정합니다. 본문은 트리거된 뒤에야 읽힙니다.
그런데 Claude는 트리거를 보수적으로 판단하는 경향이 있습니다. 자기 기본 도구로 처리할 수 있어 보이는 단순 작업에는 스킬을 부르지 않죠. 그래서 Harness는 description을 의도적으로 “pushy”하게 쓰라고 합니다.
❌ 나쁜 예: "PDF 문서를 처리하는 스킬"

✅ 좋은 예: "PDF 파일 읽기, 텍스트/테이블 추출, 병합, 분할, 회전,
   워터마크, 암호화, OCR 등 모든 PDF 작업을 수행. .pdf 파일을 언급하거나
   PDF 산출물을 요청하면 반드시 이 스킬을 사용할 것."
핵심은 스킬이 하는 일 + 구체적 트리거 상황을 모두 쓰고, 유사하지만 트리거하면 안 되는 경우와 구분되도록 경계 조건을 쓰는 것입니다.
본문 작성 원칙 5가지
| 원칙 | 설명 |
|---|---|
| Why를 설명하라 | “ALWAYS/NEVER” 같은 강압적 지시 대신 이유를 전달한다. LLM은 이유를 이해하면 엣지 케이스에서도 올바르게 판단한다 |
| Lean하게 유지 | 컨텍스트 윈도우는 공공재다. 본문은 500줄 이내를 목표로, 무게를 벌지 않는 내용은 삭제하거나 references/로 옮긴다 |
| 일반화하라 | 특정 예시에만 맞는 좁은 규칙 대신 원리를 설명한다. |
| 반복 코드는 번들링 | 에이전트들이 매번 똑같이 작성하는 스크립트가 보이면 scripts/에 미리 넣는다 |
| 명령형으로 작성 | “~한다”, “~하라”. 스킬은 지시서다 |
“Why를 설명하라”가 왜 중요한지는 예시로 보면 명확합니다.
❌ ALWAYS use pdfplumber for table extraction. NEVER use PyPDF2 for tables.

✅ 테이블 추출에는 pdfplumber를 사용한다. PyPDF2는 텍스트 추출에 특화되어
   있어 테이블의 행/열 구조를 보존하지 못하기 때문이다.
아래쪽 버전을 읽은 에이전트는 처음 보는 라이브러리를 만났을 때도 “행/열 구조를 보존하는가?”로 판단할 수 있습니다. 위쪽은 그 상황에서 아무 도움이 안 됩니다.
Progressive Disclosure — 3단계 로딩
스킬이 커지면 컨텍스트를 잡아먹습니다. Harness는 이걸 3단 로딩으로 해결합니다.
| 단계 | 로딩 시점 | 크기 목표 |
|---|---|---|
| Metadata (name + description) | 항상 컨텍스트에 존재 | ~100단어 |
| SKILL.md 본문 | 스킬이 트리거될 때 | < 500줄 |
| references/ | 필요할 때만 | 무제한 (스크립트는 로딩 없이 실행 가능) |
규칙은 단순합니다. 본문이 500줄에 근접하면 세부 내용을 references/로 분리하고, 본문에는 “언제 이 파일을 읽으라”는 포인터만 남깁니다. 300줄 넘는 레퍼런스 파일에는 상단에 목차를 답니다.
도메인별 변형이 있으면 조건부로 갈라놓습니다.
cloud-deploy/
├── SKILL.md (워크플로우 + 선택 가이드)
└── references/
    ├── aws.md    ← AWS를 고를 때만 로드
    ├── gcp.md
    └── azure.md
③ 오케스트레이터 — “언제”
개별 스킬이 “각 에이전트가 무엇을 어떻게 하는가”를 정의한다면, 오케스트레이터는 “누가 언제 어떤 순서로 협업하는가”를 정의합니다.
메인 에이전트가 사용하는 스킬이며, 하네스의 진입점입니다. 형태는 스킬이지만 역할은 지휘자이며, 메인 에이전트에게 다음을 지시합니다.
- 어떤 에이전트를 구성할지
- 어떤 스킬을 사용할지
- 작업을 어떤 순서로 실행할지
- 결과를 어떻게 통합·검증할지
- 실패나 재실행을 어떻게 처리할지
데이터 전달 프로토콜 4종
팀원들이 결과를 주고받는 방법은 넷입니다.
| 전략 | 방식 | 적용 모드 | 적합한 경우 |
|---|---|---|---|
| 메시지 기반 | SendMessage로 팀원 간 직접 통신 |
팀 | 실시간 조율, 피드백 교환, 가벼운 상태 전달 |
| 태스크 기반 | TaskCreate/TaskUpdate로 작업 상태 공유 |
팀 | 진행상황 추적, 의존 관계 관리, 작업 자체 요청 |
| 파일 기반 | 약속된 경로에 쓰고 읽음 | 팀 + 서브 | 대용량 데이터, 구조화된 산출물, 감사 추적 |
| 반환값 기반 | Agent 도구의 반환 메시지 |
서브 | 서브 에이전트 결과를 메인이 직접 수집 |
권장 조합은 모드에 따라 다릅니다. 팀 모드는 태스크(조율) + 파일(산출물) + 메시지(실시간 소통), 서브 모드는 반환값(결과 수집) + 파일(대용량 산출물)입니다.
파일 기반 전달에는 규약이 있습니다.
- 작업 디렉토리 아래
_workspace/폴더에 중간 산출물을 저장한다 - 파일명은
{phase}_{agent}_{artifact}.{ext}— 예:01_analyst_requirements.md - 최종 산출물만 사용자 지정 경로로 내보내고, 중간 파일은 삭제하지 않고 보존한다 (사후 검증·감사 추적용)
Phase 0 — 첫 실행인가, 재실행인가
오케스트레이터가 처음 하는 일은 작업이 아니라 상황 판단입니다.
_workspace/ 상태 |
사용자 요청 | 실행 모드 |
|---|---|---|
| 없음 | — | 초기 실행 — Phase 1부터 |
| 있음 | 부분 수정 요청 | 부분 재실행 — 해당 에이전트만 재호출 |
| 있음 | 새 입력 제공 | 새 실행 — 기존 _workspace/를 타임스탬프 디렉토리로 옮긴 뒤 새로 시작 |
이 분기가 없으면 하네스는 “한 번 돌리고 끝”이 됩니다. 그래서 Harness는 오케스트레이터 description에 후속 작업 키워드를 반드시 넣으라고 합니다 — “다시 실행”, “재실행”, “업데이트”, “수정”, “보완”, “이전 결과 기반으로”.
원문의 경고가 인상적입니다: 후속 키워드가 없으면 첫 실행 후 하네스가 사실상 죽은 코드가 된다.
CLAUDE.md에는 포인터만
하네스 구성이 끝나면 프로젝트의 CLAUDE.md에 등록을 합니다. 그런데 최소한만 씁니다.
## 하네스: {도메인명}

**목표:** {하네스의 핵심 목표 한 줄}

**트리거:** {도메인} 관련 작업 요청 시 `{orchestrator-skill-name}` 스킬을 사용하라.

**변경 이력:**
| 날짜 | 변경 내용 | 대상 | 사유 |
|------|----------|------|------|
| {YYYY-MM-DD} | 초기 구성 | 전체 | - |
에이전트 목록, 스킬 목록, 디렉토리 구조, 실행 규칙 상세는 넣지 않습니다. 에이전트·스킬 목록은 .claude/agents/와 .claude/skills/, 그리고 오케스트레이터 스킬이 이미 단일 출처로 관리하고 있으므로 CLAUDE.md 에 작성할 경우 중복입니다.
CLAUDE.md는 새 세션마다 로딩되므로, 하네스가 존재한다는 사실과 트리거 규칙만 알려주면 나머지는 오케스트레이터가 처리합니다.
실전 예제: 리서치 팀 한 벌 만들기
배운 걸 모아 실제 팀을 만들어 봅시다. 팬아웃/팬인 + 에이전트 팀 조합입니다.
에이전트 구성 (.claude/agents/에 각각 파일로):
| 팀원 | 에이전트 타입 | 역할 | 출력 |
|---|---|---|---|
| official-researcher | general-purpose | 공식 문서·블로그 | research_official.md |
| media-researcher | general-purpose | 미디어·투자 동향 | research_media.md |
| community-researcher | general-purpose | 커뮤니티·SNS 반응 | research_community.md |
| background-researcher | general-purpose | 배경·경쟁·학술 | research_background.md |
| (팀 리더 = 오케스트레이터) | — (메인 에이전트) | 오케스트레이터 스킬 사용, 통합 보고서 작성 | 종합보고서.md |
오케스트레이터의 팀 구성/태스크 생성 단계:
TeamCreate(team_name: "research-team", members: [
  { name: "official",   agent_type: "official-researcher",   model: "opus", prompt: "공식 채널 조사..." },
  { name: "media",      agent_type: "media-researcher",      model: "opus", prompt: "미디어/투자 동향 조사..." },
  { name: "community",  agent_type: "community-researcher",  model: "opus", prompt: "커뮤니티 반응 조사..." },
  { name: "background", agent_type: "background-researcher", model: "opus", prompt: "배경/경쟁 환경 조사..." }
])

TaskCreate(tasks: [
  { title: "공식 채널 조사", assignee: "official" },  { title: "미디어 동향 조사", assignee: "media" },
  { title: "커뮤니티 반응 조사", assignee: "community" },  { title: "배경 환경 조사", assignee: "background" }
])
팀 통신 규칙 — 여기가 팀 모드가 빛을 발하는 부분입니다.
official   ──SendMessage──→ background   (관련 공식 발표 공유)
media      ──SendMessage──→ background   (투자/인수 정보 공유)
community  ──SendMessage──→ media        (커뮤니티 반응 중 미디어 관련 정보)
모든 팀원  ──TaskUpdate──→  공유 작업 목록 (진행률 업데이트)
리더       ←──유휴 알림──── 완료된 팀원    (자동)
전체 흐름을 그림으로 보면 이렇습니다.
flowchart TD
    prep["Phase 1 · 준비<br/>입력 분석 + _workspace/ 생성"]
    create["Phase 2 · 팀 구성<br/>TeamCreate + TaskCreate"]

    subgraph P3["Phase 3 · 조사 — 4명 병렬, 팀원끼리 SendMessage로 자체 조율"]
        direction LR
        o["official"] ~~~ m["media"] ~~~ c["community"] ~~~ b["background"]
    end

    files[("_workspace/<br/>03_*_research.md × 4")]
    merge["Phase 4 · 통합<br/>리더가 Read → 종합<br/>상충 정보는 출처 병기"]
    clean["Phase 5 · 정리<br/>TeamDelete<br/>_workspace/ 보존"]

    prep --> create --> P3 --> files --> merge --> clean

    classDef ph fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    classDef worker fill:#eff6ff,stroke:#93c5fd,color:#1e3a8a;
    class prep,create,merge,clean ph;
    class o,m,c,b worker;
이 한 벌에 ‘누가·어떻게·언제’가 다 들어 있습니다.
- 누가 —
.claude/agents/의 4개 파일이 각 조사자의 조사 범위와 통신 프로토콜을 정의 - 어떻게 — 각 조사자가 참조하는 스킬이 조사 절차와 출력 형식을 정의
- 언제 — 오케스트레이터가 Phase 순서, 통합 시점, 에러 시 폴백을 정의
에러 처리도 오케스트레이터에 미리 적어둡니다. 원칙은 둘입니다 — 1회 재시도 후에도 실패하면 결과 없이 진행하되 보고서에 “해당 영역 일부 미수집”을 명시하고, 팀원 간 상충하는 데이터는 삭제하지 않고 출처를 병기합니다.
정리
Harness의 산출물은 실행 파일이 아니라 읽고 고칠 수 있는 마크다운입니다.
누가(agents/)·어떻게(skills/)·언제(오케스트레이터)를 다른 파일에 나눠 담는 이유는 하나입니다 — 따로 재사용하고 따로 고치기 위해서입니다.
에이전트는 다른 팀에도 재사용할 수 있고, 스킬은 여러 에이전트가 공유하며, 순서만 바꾸고 싶으면 오케스트레이터 한 파일만 건드립니다.
주제 3: 만든 다음은? — 검증과 진화
문제: 하네스는 만드는 순간부터 낡는다
Harness의 핵심 원칙 4번: 하네스는 고정물이 아니라 진화하는 시스템이다. 매 실행 후 피드백을 반영하고, 에이전트·스킬·CLAUDE.md를 지속 갱신한다.
그래서 워크플로우가 1→6 직선이 아니라 Phase 0부터 7까지의 루프입니다.
Phase 0 — 매번 현황부터 감사한다
하네스 스킬이 트리거되면 가장 먼저 기존 하네스 현황을 확인합니다. .claude/agents/, .claude/skills/, CLAUDE.md를 읽은 뒤 아래 표에서 현재 상황과 변경 유형에 맞는 행을 선택합니다.
Phase 0 현황 감사는 모든 경우에 선행합니다.
하네스 변경 시 실행 범위 선택표
건너뜀은 해당 변경에서 처음부터 다시 수행하지 않는다는 뜻이고, 필수는 반드시 수행해야 한다는 뜻입니다.
Phase 7은 구축 Phase가 아니라 실행 후 피드백·진화 루프이므로, Phase 1~6과 분리해 후속 절차 열에 표시합니다.
| 상황 | 변경 유형 | Phase 1 도메인 분석 |
Phase 2 팀 아키텍처 |
Phase 3 에이전트 정의 |
Phase 4 스킬 생성·수정 |
Phase 5 통합·오케스트레이션 |
Phase 6 검증 |
후속 절차 |
|---|---|---|---|---|---|---|---|---|
| 신규 구축 | — | 필수 | 필수 | 필수 | 필수 | 필수 | 필수 | 필요 시 Phase 7 진화 |
| 기존 확장 | 에이전트 추가 | 건너뜀 (Phase 0 결과 활용) |
배치 결정만 | 필수 (3-0 중복 검토 포함) |
전용 스킬 필요 시 (4-0 중복 검토 포함) |
오케스트레이터 수정 | 필수 | 필요 시 Phase 7 진화 |
| 기존 확장 | 스킬 추가·수정 | 건너뜀 | 건너뜀 | 건너뜀 | 필수 (4-0 중복 검토 포함) |
연결 변경 시 | 필수 | 필요 시 Phase 7 진화 |
| 기존 확장 | 아키텍처 변경 | 건너뜀 | 필수 | 영향받는 에이전트만 (3-0 중복 검토 포함) |
영향받는 스킬만 (4-0 중복 검토 포함) |
필수 | 필수 | 필요 시 Phase 7 진화 |
| 운영·유지보수 | 점검·수정·동기화 | — | — | — | — | — | 변경 범위에 맞는 검증 | Phase 7-5 워크플로우 |
예를 들어 기존 스킬의 내용만 수정하면 Phase 4 → Phase 6만 수행하고, 새 에이전트를 추가하면 배치 결정·에이전트 정의·오케스트레이터 연결·검증까지 수행합니다.
점검·수정·동기화 요청은 일반 확장 매트릭스가 아니라 Phase 7-5의 운영·유지보수 절차로 진입합니다.
그리고 drift 감지를 합니다. 실제 파일 목록과 CLAUDE.md의 기록을 대조해 불일치를 찾아내죠. 파일은 지웠는데 기록은 남아 있거나, 그 반대인 경우를 잡습니다.
중복이 쌓이는 걸 막는다
하네스를 반복해서 구축하다 보면 역할이 겹치는 에이전트가 다른 이름으로 누적되기 쉽습니다. 그래서 Phase 3과 4 앞에 재사용 검토 단계(3-0, 4-0)가 붙습니다.
| 상황 | 조치 |
|---|---|
| 기존 것이 신규 역할을 완전히 포함 | 신규 생성 금지 — 기존 것 재사용 |
| 기존 것이 부분 포함이고 일반화 가능 | 기존 것을 일반화하여 확장 |
| 도메인 특화가 의도된 부분 포함 | 신규 생성 진행 — 별개로 유지 |
| 범위가 완전히 다름 | 신규 생성 진행 |
여기서 미묘한 지점이 하나 있습니다. 일반화는 어디까지 해야 하나? 일반화는 무한히 가능하기 때문에, Harness는 “의도된 책임 범위”에서 멈추라고 합니다.
flowchart TD
    start(["fintech 리스크 평가 PDF<br/>스킬"])
    intent{"'fintech 리스크 평가'가<br/>의도된 특화인가?"}
    keep["일반화하지 않음<br/>별도 스킬로 유지<br/>의도된 특화 보존"]
    step1["1단계<br/>fintech 종속 제거<br/>→ 평가 결과 PDF"]
    report{"책임 범위가<br/>'평가 리포트'인가?"}
    stop["여기서 중단<br/>평가 리포트 범위 유지"]
    step2["2단계<br/>평가 종속 제거<br/>→ PDF 포매팅"]
    exists{"동일한 기능의 스킬이<br/>이미 존재하는가?"}
    reuse["새로 만들지 않음<br/>기존 스킬 재사용"]
    generic["일반화된 PDF 포매팅<br/>스킬로 유지·생성"]

    start --> intent
    intent -->|예| keep
    intent -->|아니오| step1
    step1 --> report
    report -->|예| stop
    report -->|아니오| step2
    step2 --> exists
    exists -->|예| reuse
    exists -->|아니오| generic

    classDef startStyle fill:#dbeafe,stroke:#2563eb,stroke-width:2px,color:#1e3a8a;
    classDef decisionStyle fill:#fef3c7,stroke:#d97706,color:#78350f;
    classDef actionStyle fill:#eff6ff,stroke:#93c5fd,color:#1e3a8a;
    classDef stopStyle fill:#dcfce7,stroke:#16a34a,color:#14532d;
    class start startStyle;
    class intent,report,exists decisionStyle;
    class step1,step2 actionStyle;
    class keep,stop,reuse,generic stopStyle;
스킬의 값어치를 어떻게 증명하나 — With-skill vs Baseline
스킬을 하나 만들었습니다. 그런데 이게 정말 도움이 되나요? Claude는 스킬 없이도 웬만한 건 합니다. 그래서 Harness는 A/B 실행으로 확인하라고 합니다.
각 테스트 프롬프트마다 서브에이전트 두 개를 동시에 스폰합니다.
flowchart TD
    p["동일한 테스트 프롬프트"]
    w["🅰 With-skill<br/>스킬을 읽고 작업 수행"]
    b["🅱 Baseline<br/>같은 프롬프트, 스킬 없이"]
    g{"assertion 기반 채점<br/>+ 사용자 정성 리뷰"}
    keep["✅ 차이가 있다 → 스킬 유지"]
    fix["🔁 차이가 없다 → 스킬 수정<br/>또는 assertion 교체"]

    p --> w --> g
    p --> b --> g
    g --> keep
    g --> fix
    fix -.->|"다음 iteration"| p

    classDef a fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    classDef bb fill:#fef3c7,stroke:#d97706,color:#78350f;
    class w,keep a;
    class b,fix bb;
객관적으로 검증 가능한 산출물(파일 생성, 데이터 추출 등)에는 assertion을 정의해 자동 채점합니다. 결과 스키마는 이렇습니다.
{
  "expectations": [
    { "text": "이익률 열이 추가됨",     "passed": true,  "evidence": "E열에 'profit_margin_pct' 확인" },
    { "text": "이익률 기준 내림차순 정렬", "passed": false, "evidence": "정렬 없이 원본 순서 유지됨" }
  ],
  "summary": { "passed": 1, "failed": 1, "total": 2, "pass_rate": 0.50 }
}
여기서 가장 중요한 개념이 non-discriminating assertion입니다. “두 구성 모두에서 100% 통과”하는 assertion은 스킬의 차별적 가치를 전혀 측정하지 못합니다. “출력이 존재한다” 같은 것이죠. 이런 assertion을 발견하면 제거하거나 더 도전적인 것으로 교체합니다.
테스트 프롬프트 자체도 품질 기준이 있습니다. 실제 사용자가 입력할 법한 구체적이고 자연스러운 문장이어야 합니다. “PDF를 처리하라”가 아니라 “다운로드 폴더의 ‘Q4_매출_최종_v2.xlsx’에서 C열과 D열로 이익률 열을 추가하고 내림차순 정렬해줘” 쪽이죠. 추상적인 프롬프트는 테스트 가치가 낮습니다.
그리고 각 iteration은 독립 디렉토리에 보존합니다. iteration-1/, iteration-2/… 이전 것을 덮어쓰지 않아야 개선이 실제로 일어났는지 비교할 수 있습니다. eval 디렉토리 이름도 숫자가 아니라 eval-multi-page-table-extraction처럼 서술적으로 붙입니다.
트리거는 어떻게 검증하나 — near-miss가 핵심
스킬 본문이 아무리 훌륭해도 트리거되지 않으면 존재하지 않는 것과 같습니다. description이 유일한 트리거 메커니즘이니, description 자체를 테스트해야 합니다.
방법은 20개의 쿼리를 쓰는 것입니다.
- Should-trigger 쿼리 8~10개 — 같은 의도의 다양한 표현(공식적/캐주얼), 파일 유형을 명시하지 않지만 분명히 필요한 경우, 비주류 사용 사례
- Should-NOT-trigger 쿼리 8~10개 — 키워드는 비슷하지만 다른 도구/스킬이 적합한 near-miss 쿼리
near-miss가 핵심입니다. Harness는 이 점을 명확히 합니다.
“피보나치 함수 작성” 같이 명백히 무관한 쿼리는 테스트 가치가 없다. “이 엑셀 파일의 차트를 PNG로 추출해줘”(xlsx 스킬 vs 이미지 변환)처럼 경계가 모호한 쿼리가 좋은 테스트 케이스다.
경계가 모호한 곳에서만 description의 경계 조건이 시험받기 때문입니다.
flowchart TD
    d["description 작성"]
    q["20개 쿼리 실행<br/>should-trigger 10<br/>+ should-NOT-trigger 10"]
    check{"트리거 결과가<br/>기대와 일치?"}
    ok["✅ 확정"]
    fail["실패 케이스 분석"]
    fix["description 경계 조건 보강<br/>(누락 표현 추가 / 제외 조건 명시)"]
    conflict["기존 스킬과의<br/>트리거 충돌도 이 단계에서 확인"]

    d --> q --> check
    check -->|"Yes"| ok
    check -->|"No"| fail --> fix --> q
    q -.-> conflict

    classDef good fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    class ok,d good;
기존 스킬과의 트리거 충돌도 이 단계에서 봅니다. 새 스킬의 should-trigger 쿼리가 엉뚱하게 기존 스킬을 부르지는 않는지 확인하고, 충돌이 있으면 경계 조건을 더 명확히 씁니다.
Phase 7 — 사용자 피드백을 어디에 적용하는가
매 실행이 끝나면 사용자에게 피드백을 요청합니다. “결과에서 개선할 부분이 있나요?”, “팀 구성이나 워크플로우에 바꾸고 싶은 점이 있나요?” 피드백이 없으면 넘어갑니다. 강요하지 않되 반드시 기회를 제공합니다.
핵심은 피드백의 유형에 따라 고칠 파일이 다르다는 것입니다.
| 피드백 유형 | 수정 대상 | 예시 |
|---|---|---|
| 결과물 품질 | 해당 에이전트의 스킬 | “분석이 너무 피상적” → 스킬에 깊이 기준 추가 |
| 에이전트 역할 | 에이전트 정의 .md |
“보안 검토도 필요” → 새 에이전트 추가 |
| 워크플로우 순서 | 오케스트레이터 스킬 | “검증을 먼저 해야” → Phase 순서 변경 |
| 팀 구성 | 오케스트레이터 + 에이전트 | “이 둘은 합쳐도 될 듯” → 에이전트 병합 |
| 트리거 누락 | 스킬 description | “이 표현으로 하면 작동 안 함” → description 확장 |
주제 2에서 파일을 셋으로 나눈 이유가 여기서 드러납니다.
“누가/어떻게/언제”를 물리적으로 분리해 뒀기 때문에, 피드백을 받았을 때 어디를 고칠지가 자동으로 정해집니다.
하나의 거대한 프롬프트였다면 “분석이 피상적”이라는 피드백에 어디를 손대야 할지 알 수 없었을 겁니다.
모든 변경은 CLAUDE.md의 변경 이력 테이블에 기록합니다.
**변경 이력:**
| 날짜 | 변경 내용 | 대상 | 사유 |
|------|----------|------|------|
| 2026-04-05 | 초기 구성 | 전체 | - |
| 2026-04-07 | QA 에이전트 추가 | agents/qa.md | 산출물 품질 검증 부족 피드백 |
| 2026-04-10 | 톤 가이드 추가 | skills/content-creator | "너무 딱딱하다" 피드백 |
이 이력이 있어야 하네스가 어느 방향으로 진화했는지 추적할 수 있고, 퇴행(regression)을 방지할 수 있습니다. “왜 이 규칙이 여기 있지?”에 답할 수 있으면 그 규칙을 실수로 되돌리지 않습니다.
마지막으로, 진화는 사용자가 “하네스 수정해줘”라고 말할 때만 일어나는 게 아닙니다. Harness는 자동 진화 트리거 셋을 정의합니다.
- 같은 유형의 피드백이 2회 이상 반복될 때
- 에이전트가 반복적으로 실패하는 패턴이 발견될 때
- 사용자가 오케스트레이터를 우회하여 수동으로 작업하는 것이 관찰될 때
세 번째가 특히 날카롭습니다. 사용자가 하네스를 안 쓰고 손으로 하고 있다면, 그건 하네스가 그 일에 안 맞는다는 가장 강한 신호입니다.
전체 루프를 그림으로 보면 이렇습니다.
flowchart TD
    p0["Phase 0 · 현황 감사<br/>신규 / 확장 / 운영 분기"]
    p12["Phase 1–2 · 도메인 분석<br/>+ 팀 아키텍처 설계"]
    p34["Phase 3–4 · 에이전트 · 스킬 생성<br/>(3-0 · 4-0 재사용 검토 선행)"]
    p5["Phase 5 · 통합 · 오케스트레이션<br/>+ CLAUDE.md 포인터 등록"]
    p6["Phase 6 · 검증<br/>A/B · 트리거 · 드라이런"]
    p7["Phase 7 · 진화<br/>피드백 → 수정 대상 매핑<br/>+ 변경 이력 기록"]

    p0 --> p12 --> p34 --> p5 --> p6 --> p7
    p7 -->|"다음 실행"| p0

    classDef loop fill:#dbeafe,stroke:#2563eb,color:#1e3a8a;
    classDef evo fill:#fef3c7,stroke:#d97706,color:#78350f;
    class p0,p12,p34,p5 loop;
    class p6,p7 evo;
정리
하네스는 산출물이 아니라 자산입니다.
자산이려면 두 가지가 필요합니다:
— 측정할 수 있어야 하고(스킬이 실제로 값어치가 있는지 A/B로, 트리거가 실제로 걸리는지 near-miss로, 모듈이 실제로 연결되는지 경계면 교차 비교로),
— 고친 이력이 남아야 합니다(어디를 왜 고쳤는지가 변경 이력에).
세 주제를 관통하는 하나의 아이디어
지금까지 세 가지를 봤습니다.
- 왜 팀인가 — 일을 전문 영역으로 나누고, 나눈 것들이 서로 대화하게 만든다
- 어떻게 적나 — 누가·어떻게·언제를 각각 다른 파일에 담는다
- 만든 다음은 — 측정하고, 피드백을 되먹이고, 이력을 남긴다
이 셋은 사실 같은 원리의 세 얼굴입니다.
flowchart LR
    A["① 팀 아키텍처<br/>역할을 실행 전에<br/>나눈다 (구조)"] --> P
    B["② 산출물 문법<br/>나눈 구조를<br/>파일로 남긴다 (자산화)"] --> P
    C["③ 검증과 진화<br/>남긴 파일을 측정하고<br/>고친다 (누적)"] --> P
    P(["일회성 지시를<br/>재사용 가능한 조직으로"])
    style P fill:#dbeafe,stroke:#2563eb,stroke-width:2px,color:#1e3a8a
팀을 즉흥으로 소집하지 말고, 설계해서 파일로 남겨라.
- 매번 프롬프트로 역할을 설명하는 대신, 역할을 실행 전에 나눠 확정한다 (주제 1)
- 그 설계를 대화 속에 흘려보내지 않고, 누가·어떻게·언제로 갈라 파일에 담는다 (주제 2)
- 담긴 파일이 정말 값어치가 있는지 측정하고, 피드백이 어디로 가야 할지 자동으로 정해지게 한다 (주제 3)
세 번째가 두 번째 없이는 불가능하고, 두 번째는 첫 번째 없이는 의미가 없다는 점에 주목하세요. 역할을 나누지 않으면 파일로 나눌 게 없고, 파일로 나누지 않으면 “이 피드백은 어디를 고쳐야 하나”에 답할 수 없습니다. 분리가 곧 개선 가능성입니다.
이것이 Harness가 내놓은 답입니다. 프롬프트를 더 잘 쓰려고 애쓰는 대신, 팀을 설계하고 그 설계를 자산으로 남겨라. 그러면 다음 세션에서, 다음 프로젝트에서, 그리고 다음 피드백을 받았을 때 — 처음부터 다시 시작하지 않아도 됩니다.
이 문서는 Harness 저장소의 메타 스킬 정의(skills/harness/SKILL.md)와 6개 레퍼런스 문서(agent-design-patterns, orchestrator-template, team-examples, skill-writing-guide, skill-testing-guide, qa-agent-guide)를 분석해 작성했습니다. 실제로 하네스를 만들어 보려면 docs/quickstart.md의 5분 가이드를 따라가면 됩니다. 에이전트 팀 기능은 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 환경변수를 필요로 하며, 이 실험 플래그의 향후 시나리오는 docs/experimental-dependency.md에 정리되어 있습니다.